Embeddings e bases de datos vectoriais
A limitación da busca directa nos documentos
Un RAG pode buscar directamente nos documentos, pero este enfoque ten algunhas limitacións.
Se para cada pregunta lle entregamos todos os documentos ao modelo, o texto ocupa moitos tokens. Canto maior sexa a colección de documentos, máis información innecesaria terá que procesar o modelo.
Ademais, unha busca baseada só nas palabras exactas pode non atopar un texto relevante. Por exemplo, podemos formular estas dúas preguntas:
- «Como configurar unha rede sen fíos?»
- «Pasos para establecer unha conexión Wi-Fi».
As palabras son diferentes, pero o significado é moi similar. Unha busca literal que procure exactamente as mesmas palabras pode non relacionar as dúas frases.
Que é un embedding?
Un embedding é unha representación numérica dun texto. Un método de embedding analiza o significado do texto e convérteo nunha lista de números chamada vector.
Podemos imaxinar un espazo de dúas dimensións para entendelo mellor. Cada texto sería un punto cunha posición determinada:
Texto A: «Como configurar unha rede sen fíos?»  -> (0,80; 0,75)
Texto B: «Pasos para establecer unha conexión Wi-Fi» -> (0,78; 0,73)
Texto C: «Receita para preparar unha sobremesa»    -> (0,15; 0,20)
A distancia entre os dous primeiros puntos é pequena, polo que o sistema pode considerar que as súas preguntas teñen un significado parecido. A distancia ata o terceiro punto é maior, polo que ese texto resulta menos relevante.
Os valores anteriores son só ilustrativos. Nun sistema real, os embeddings adoitan ter moitas máis dimensións, polo que non podemos debuxalos facilmente. O importante é a relación entre os puntos: os textos con significado similar deberían quedar próximos no espazo vectorial.
Dividir os documentos: chunking
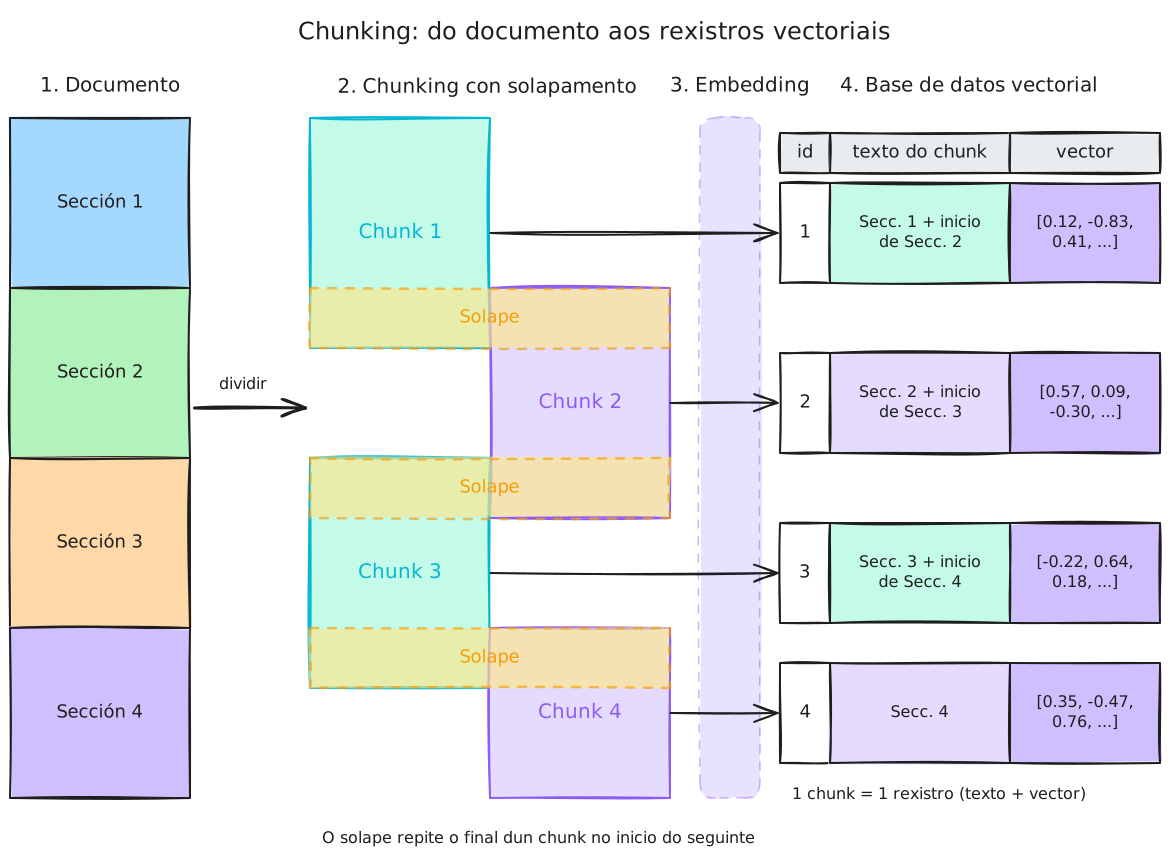
Antes de converter un documento nun embedding, normalmente dividímolo en fragmentos máis pequenos. Este proceso chámase chunking e cada fragmento recibe o nome de chunk.
Por exemplo, un manual pode dividirse por apartados ou por grupos de parágrafos. Cada chunk debe conter información suficiente para entender unha idea concreta. Despois xérase un embedding para cada fragmento, en lugar de crear un único vector para todo o manual.
Ao dividir un documento, unha idea pode comezar ao final dun fragmento e continuar no seguinte. Para non perder esa relación, podemos facer que unha parte do final dun chunk se repita ao comezo do seguinte. Isto chámase solapamento (overlap).
Por exemplo, podemos crear estes fragmentos:
- Chunk 1: frases 1, 2 e 3.
- Chunk 2: frases 3, 4 e 5.
A frase 3 aparece nos dous fragmentos. Se unha pregunta se refire a esa frase, calquera dos dous chunks conservará parte do contexto necesario para comprendela.
O solapamento pode mellorar a recuperación de información, pero tamén aumenta o número de fragmentos, os embeddings que debemos xerar e os datos que debemos gardar. Por iso debemos escoller un tamaño de chunk e un solapamento axeitados ao tipo de documentos.
O tamaño dos fragmentos é importante:
- Se son demasiado grandes, poden conter información innecesaria e ocupar máis tokens cando se lle entregan ao modelo.
- Se son demasiado pequenos, poden perder parte do contexto necesario para comprender a información.
O obxectivo é crear fragmentos que poidan responder, total ou parcialmente, a unha pregunta. Cada un debe gardarse xunto co texto orixinal para poder recuperalo despois da busca vectorial.
Que necesitamos?
Para construír un sistema que busque por significado necesitamos tres elementos:
- Un método para xerar embeddings. Converte cada texto nun vector. O mesmo método debe converter tanto os documentos como as preguntas.
- Unha base de datos vectorial. Garda os embeddings e permite buscar os vectores máis próximos ao vector da pregunta.
- Un vínculo co texto orixinal. Cada vector debe conservar unha referencia ao documento ou ao fragmento de texto do que procede. Así podemos recuperar o contido real e entregarllo ao modelo.
pgvector?pgvector é unha extensión de PostgreSQL que permite gardar vectores nas súas
táboas e realizar buscas por proximidade entre eles. Así podemos utilizar unha
base de datos PostgreSQL para almacenar os embeddings, os chunks e a relación
entre cada vector e o seu texto orixinal.
Como se utiliza nun RAG?
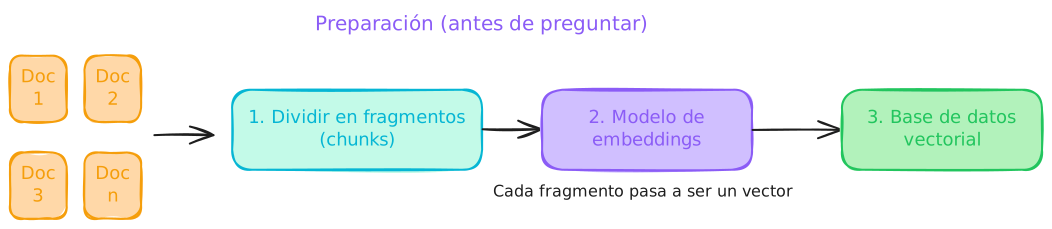
Antes de recibir preguntas, o sistema prepara os documentos:
- Aplica chunking para dividir os documentos en fragmentos manexables.
- Xera un embedding para cada fragmento.
- Garda cada vector xunto co seu texto orixinal e os seus datos identificativos.
Cando a persoa fai unha pregunta, o sistema segue un proceso parecido:
- A persoa fai unha pregunta. Por exemplo: «Como configurar unha rede sen fíos?».
- O sistema converte a pregunta nun prompt de consulta e xera o seu embedding co mesmo método utilizado para os documentos.
- O sistema busca na base de datos os fragmentos axeitados. Selecciona os
fragmentos cuxos vectores están a unha distancia menor ou igual ca
rdo vector da consulta.ré a distancia máxima que imos permitir. - O sistema entrega os fragmentos ao modelo xunto co prompt de consulta.
- O modelo redacta a resposta e devólvella á persoa usuaria.
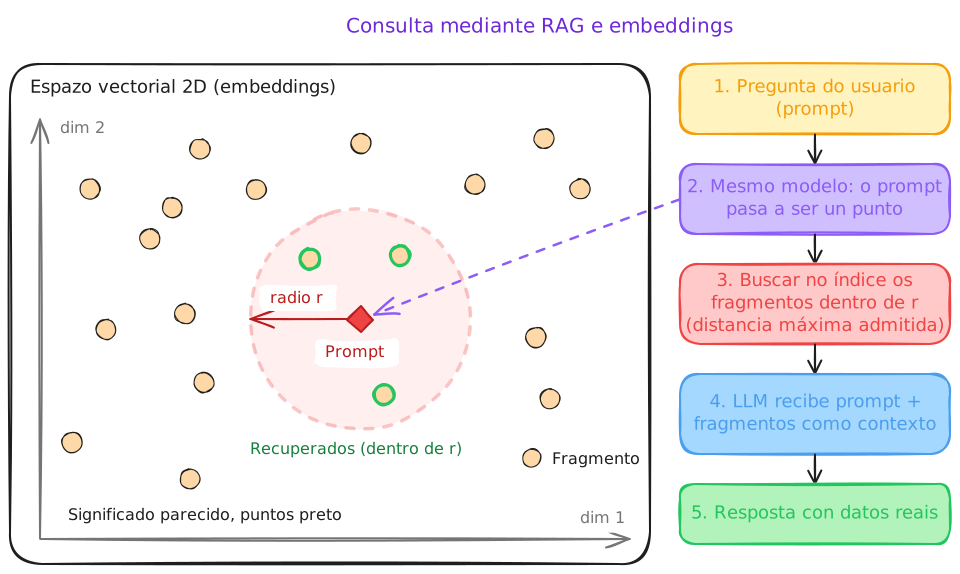
Deste xeito, o modelo non necesita recibir todos os documentos. Recibe só os fragmentos que probablemente son útiles para responder á pregunta.
Como sabemos se dous vectores son próximos?
Precisamos unha métrica de distancia. É unha función que recibe dous puntos ou dous vectores e devolve un valor que indica o afastados que están. Canto menor sexa a distancia, máis próximos son os vectores segundo esa métrica.
As métricas máis habituais son:
| Métrica | Idea principal | Nome habitual en pgvector |
|---|---|---|
| Distancia Manhattan | Suma as diferenzas percorridas en cada dimensión. | L1 |
| Distancia Euclidiana | Calcula a distancia en liña recta entre os puntos. | L2 |
| Distancia do coseno | Compara a orientación dos vectores, non só o seu tamaño. | Coseno |
En pgvector, estas métricas están dispoñibles mediante operadores específicos:
<+>para a distancia Manhattan, tamén chamada L1;<->para a distancia Euclidiana, tamén chamada L2;<=>para a distancia do coseno.
Non existe unha única métrica que sexa sempre a mellor. A elección depende do método utilizado para xerar os embeddings e do tipo de información que estamos a buscar.
Resumo
Os embeddings permiten representar textos como vectores. Unha base de datos vectorial pode comparar o vector dunha pregunta cos vectores dos documentos e recuperar os textos semanticamente máis próximos.
Así, un RAG pode atopar información relacionada aínda que a pregunta e o documento utilicen palabras diferentes, e pode enviar ao modelo só o contexto necesario para elaborar a resposta.