Sistema RAG para documentos do centro
Nesta práctica imos construír un sistema RAG que responderá preguntas sobre os documentos oficiais dun centro educativo. A aplicación utilizará os fragmentos almacenados nunha base de datos vectorial para achegar contexto a un modelo de linguaxe.
O sistema terá estes compoñentes:
| Compoñente | Función |
|---|---|
PostgreSQL con pgvector | Garda os fragmentos e os seus embeddings. |
| Ollama | Executa localmente os modelos de embeddings e de linguaxe. |
Modelo de Ollama nomic-embed-text | Converte textos en vectores de 768 dimensións. |
Modelo de Ollama qwen2.5:3b | Elabora a resposta a partir da pregunta e do contexto recuperado. |
| Python | Xera embeddings, consulta a base de datos e constrúe as respostas. |
Ollama é unha ferramenta que permite executar modelos de linguaxe directamente
no noso equipo ou nun contedor, sen depender dun servizo externo. No exercicio
utilizámola para executar os modelos nomic-embed-text e qwen2.5:3b.
O primeiro modelo converte os textos en embeddings para poder buscar fragmentos semellantes. O segundo le a pregunta e o contexto recuperado e redacta a resposta. Deste xeito, todo o procesamento do exemplo queda dentro do noso proxecto e podemos probar o sistema sen configurar unha API de pago.
Estrutura da base de datos
Neste exemplo a base de datos só ten unha táboa: fragmentos. Cada fila
contén un fragmento dun documento e, despois de executar embedding.py, o seu
vector correspondente.
O campo embedding é un vector de 768 dimensións. Non hai relacións con
outras táboas neste exemplo: a información do documento e a categoría gárdanse
directamente en cada fragmento.
Que necesitamos?
Necesitamos ter instalado Docker Desktop ou Docker Engine con Docker Compose. O proxecto debe conter, como mínimo, estes ficheiros:
.
├── Dockerfile
├── compose.yaml
├── init.sql
├── embedding.py
└── buscar.py
Cada ficheiro ten unha responsabilidade concreta:
Dockerfile: describe como construír a imaxe que executará os programas Python.compose.yaml: define os contedores, a rede, os portos e os volumes do proxecto.init.sql: activapgvector, crea a táboafragmentose insire os documentos iniciais.embedding.py: crea un embedding para cada fragmento que aínda non o ten e gárdao en PostgreSQL.buscar.py: recibe unha pregunta, recupera os fragmentos máis próximos e pide a Ollama que redacte a resposta.
Dockerfile
O Dockerfile parte da imaxe de Python 3.12, establece /app como cartafol de
traballo, instala as bibliotecas necesarias e copia o código ao contedor.
FROM python:3.12-slim

WORKDIR /app

RUN pip install --no-cache-dir requests psycopg2-binary

COPY . .

CMD ["python", "buscar.py"]
O CMD indica que, se iniciamos directamente este contedor, executará
buscar.py. Na práctica desta páxina lanzámolo baixo demanda con
docker compose run.
embedding.py
Este programa busca os fragmentos cuxo campo embedding aínda está baleiro.
Para cada un, envía o texto ao modelo de Ollama nomic-embed-text, comproba
que o vector ten 768 dimensións e gárdao na táboa.
import json
import requests
import psycopg2

# Conexión coa base de datos
conn = psycopg2.connect(
    host="postgres",
    database="rag",
    user="rag",
    password="abc123"
)

cur = conn.cursor()

# Recuperar os fragmentos sen embedding
cur.execute("""
    SELECT id, contido
    FROM fragmentos
    WHERE embedding IS NULL
""")

fragmentos = cur.fetchall()

print(f"Fragmentos pendentes: {len(fragmentos)}")

# Xerar e gardar os embeddings
for id_fragmento, contido in fragmentos:

    resposta = requests.post(
        "http://ollama:11434/api/embed",
        json={
            "model": "nomic-embed-text",
            "input": contido
        },
        timeout=120
    )

    resposta.raise_for_status()

    vector = resposta.json()["embeddings"][0]

    if len(vector) != 768:
        raise ValueError("O embedding non ten 768 dimensións")

    cur.execute(
        """
        UPDATE fragmentos
        SET embedding = %s::vector
        WHERE id = %s
        """,
        (json.dumps(vector), id_fragmento)
    )

    conn.commit()

    print(f"Fragmento {id_fragmento} procesado correctamente")

cur.close()
conn.close()

print("\nTodos os embeddings foron xerados.")
buscar.py
Este é o programa interactivo. Converte a pregunta nun embedding, busca os dous
fragmentos máis similares mediante a distancia do coseno e envía o contexto ao
modelo de Ollama qwen2.5:3b.
import json
import requests
import psycopg2

# 1. Recibir a pregunta
pregunta = input("\nEscribe unha pregunta: ").strip()

if not pregunta:
    print("Tes que introducir unha pregunta.")
    exit()

# 2. Xerar o embedding da pregunta
resposta = requests.post(
    "http://ollama:11434/api/embed",
    json={
        "model": "nomic-embed-text",
        "input": pregunta
    },
    timeout=120
)

resposta.raise_for_status()

embedding = json.dumps(resposta.json()["embeddings"][0])

# 3. Conectar con PostgreSQL
conn = psycopg2.connect(
    host="postgres",
    database="rag",
    user="rag",
    password="abc123"
)

cur = conn.cursor()

# 4. Recuperar os dous fragmentos máis similares
cur.execute("""
    SELECT
        documento,
        categoria,
        contido,
        1 - (embedding <=> %s::vector) AS similitude
    FROM fragmentos
    WHERE embedding IS NOT NULL
    ORDER BY embedding <=> %s::vector
    LIMIT 2
""", (embedding, embedding))

resultados = cur.fetchall()

cur.close()
conn.close()

# 5. Construír o contexto
contexto = "\n\n".join(
    f"Documento: {documento}\n"
    f"Categoría: {categoria}\n"
    f"Contido: {contido}"
    for documento, categoria, contido, similitude in resultados
)

# 6. Amosar os fragmentos recuperados
print("\n--- CONTEXTO RECUPERADO ---")

for documento, categoria, contido, similitude in resultados:
    print(f"\nDocumento: {documento}")
    print(f"Categoría: {categoria}")
    print(f"Similitude: {similitude:.4f}")
    print(f"Contido: {contido}")

# 7. Xerar a resposta co modelo Qwen
resposta = requests.post(
    "http://ollama:11434/api/chat",
    json={
        "model": "qwen2.5:3b",
        "messages": [
            {
                "role": "system",
                "content": (
                    "Es un asistente educativo. Responde en galego "
                    "utilizando a información do contexto proporcionado. "
                    "Non inventes información. Se o contexto non permite "
                    "responder, indica que non hai información suficiente."
                )
            },
            {
                "role": "user",
                "content": (
                    f"Contexto:\n{contexto}\n\n"
                    f"Pregunta: {pregunta}"
                )
            }
        ],
        "stream": False
    },
    timeout=300
)

resposta.raise_for_status()

# 8. Amosar a resposta final
print("\n--- RESPOSTA DO ASISTENTE ---\n")
print(resposta.json()["message"]["content"])
compose.yaml
Creamos compose.yaml co seguinte contido:
services:
  postgres:
    image: pgvector/pgvector:pg17-bookworm
    container_name: rag-postgres
    restart: unless-stopped
    environment:
      POSTGRES_DB: rag
      POSTGRES_USER: rag
      POSTGRES_PASSWORD: abc123
    ports:
      - '5433:5432'
    volumes:
      - postgres_data:/var/lib/postgresql/data
      - ./init.sql:/docker-entrypoint-initdb.d/init.sql:ro
    networks:
      - rag-network

  ollama:
    image: ollama/ollama
    container_name: ollama
    restart: unless-stopped
    ports:
      - '11434:11434'
    volumes:
      - ollama_data:/root/.ollama
    networks:
      - rag-network

  ollama-init:
    image: ollama/ollama
    container_name: ollama-init
    depends_on:
      - ollama
    environment:
      OLLAMA_HOST: http://ollama:11434
    entrypoint: ['/bin/sh', '-c']
    command:
      - |
        until ollama list >/dev/null 2>&1; do
          sleep 2
        done
        ollama pull nomic-embed-text
        ollama pull qwen2.5:3b
    restart: 'no'
    networks:
      - rag-network

  python:
    build: .
    container_name: rag-python
    depends_on:
      - postgres
      - ollama
    volumes:
      - .:/app
    networks:
      - rag-network
    profiles:
      - app

volumes:
  postgres_data:
  ollama_data:

networks:
  rag-network:
    name: curso-rag_rag-network
    driver: bridge
O servizo postgres publica o porto 5433 do equipo anfitrión e conéctao co
porto 5432 do contedor. O servizo ollama publica o porto 11434. Dentro da
rede de Compose, os programas poden localizar estes servizos polos nomes
postgres e ollama.
ollama-init agarda a que Ollama estea dispoñible e descarga os dous modelos
necesarios. Como ten restart: "no", remata e desaparece cando finaliza
correctamente.
abc123 aparece neste exemplo unicamente para facer a práctica nun entorno
local e illado. Nun sistema real debes substituílo por un contrasinal longo,
único e difícil de adiviñar. Non publiques contrasinais reais no ficheiro
Compose nin os gardes nun repositorio. É preferible empregar variables de
contorno ou un xestor de segredos.
init.sql
O ficheiro init.sql execútase automaticamente a primeira vez que se crea o
volume de PostgreSQL. Activa pgvector, crea a táboa e insire os fragmentos
dos documentos oficiais do centro.
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE fragmentos (
    id SERIAL PRIMARY KEY,
    documento VARCHAR(100) NOT NULL,
    categoria VARCHAR(100) NOT NULL,
    contido TEXT NOT NULL,
    embedding VECTOR(768)
);

INSERT INTO fragmentos (documento, categoria, contido) VALUES
('asistencia.md', 'Asistencia', 'Todo o alumnado debe asistir puntualmente ás actividades lectivas. A asistencia regular é fundamental para acadar os resultados de aprendizaxe previstos no módulo.'),
('asistencia.md', 'Asistencia', 'As faltas de asistencia deben xustificarse ante o titor ou titora mediante o procedemento establecido polo centro educativo.'),
('asistencia.md', 'Asistencia', 'Cando un alumno acumula faltas de asistencia inxustificadas, o titor debe contactar co alumno para coñecer os motivos e intentar solucionar a situación.'),
('asistencia.md', 'Asistencia', 'Se un alumno menor de idade falta reiteradamente ás clases, o centro debe informar as persoas responsables legais segundo o protocolo de absentismo.'),
('asistencia.md', 'Asistencia', 'O profesorado debe rexistrar diariamente as faltas de asistencia e puntualidade na aplicación de xestión académica utilizada polo centro.'),
('avaliacion.md', 'Avaliación', 'A avaliación na formación profesional debe comprobar se o alumnado adquiriu os resultados de aprendizaxe e alcanzou os criterios de avaliación establecidos no currículo.'),
('avaliacion.md', 'Avaliación', 'Cada módulo profesional dispón de criterios de avaliación que permiten valorar os coñecementos, habilidades e competencias adquiridas polo alumnado.'),
('avaliacion.md', 'Avaliación', 'A cualificación dos módulos profesionais exprésase numericamente de 1 a 10, sen decimais. Considérase positiva unha cualificación igual ou superior a 5.'),
('avaliacion.md', 'Avaliación', 'O profesorado debe informar o alumnado dos criterios de avaliación, dos instrumentos utilizados e dos procedementos de cualificación ao comezo do curso.'),
('avaliacion.md', 'Avaliación', 'As probas prácticas permiten comprobar se o alumnado é capaz de aplicar os coñecementos adquiridos na resolución de problemas técnicos reais.'),
('avaliacion.md', 'Avaliación', 'Os instrumentos de avaliación poden incluír probas escritas, exercicios prácticos, proxectos, observación directa e actividades realizadas na aula.'),
('convivencia.md', 'Convivencia', 'O alumnado debe manter unha actitude de respecto cara ao profesorado, aos compañeiros e ao resto do persoal do centro educativo.'),
('convivencia.md', 'Convivencia', 'As faltas de respecto ao profesorado ou aos compañeiros serán comunicadas á xefatura de estudos. Dependendo da gravidade, poderán aplicarse medidas correctoras.'),
('convivencia.md', 'Convivencia', 'Non está permitido danar intencionadamente o material informático, o mobiliario ou as instalacións do centro.'),
('convivencia.md', 'Convivencia', 'O alumnado debe utilizar os equipos informáticos e os recursos tecnolóxicos exclusivamente para as actividades autorizadas polo profesorado.'),
('convivencia.md', 'Convivencia', 'Os conflitos entre estudantes deben tratarse inicialmente mediante o diálogo e a mediación, sempre que a situación o permita.'),
('recursos.md', 'Recursos educativos', 'Antes de utilizar unha imaxe, un vídeo ou outro material descargado de Internet nun recurso educativo, débese comprobar a súa licenza e as condicións de reutilización.'),
('recursos.md', 'Recursos educativos', 'As licenzas Creative Commons permiten compartir e reutilizar recursos educativos baixo determinadas condicións. Algunhas licenzas permiten modificacións e usos comerciais, mentres que outras os restrinxen.'),
('recursos.md', 'Recursos educativos', 'A licenza CC BY permite reutilizar, distribuír e adaptar unha obra, mesmo con fins comerciais, sempre que se recoñeza a autoría orixinal.'),
('recursos.md', 'Recursos educativos', 'A licenza CC BY-SA permite modificar e compartir unha obra, incluso con fins comerciais, pero as obras derivadas deben manter a mesma licenza.'),
('recursos.md', 'Recursos educativos', 'A licenza CC BY-NC permite reutilizar e modificar unha obra sempre que non se faga un uso comercial e se recoñeza a autoría.'),
('recursos.md', 'Recursos educativos', 'A licenza CC BY-ND permite compartir unha obra, mesmo con fins comerciais, pero non autoriza a distribución de versións modificadas.'),
('recursos.md', 'Recursos educativos', 'Se unha imaxe non indica ningunha licenza, non se debe asumir que é libre de dereitos. Cómpre solicitar autorización ou buscar unha alternativa con permisos de reutilización.'),
('proteccion-datos.md', 'Protección de datos', 'O profesorado debe protexer os datos persoais do alumnado e utilizalos exclusivamente para finalidades educativas e administrativas lexítimas.'),
('proteccion-datos.md', 'Protección de datos', 'Non se deben publicar cualificacións, datos persoais ou información académica do alumnado en espazos públicos ou accesibles a persoas non autorizadas.'),
('proteccion-datos.md', 'Protección de datos', 'As fotografías do alumnado identificable son datos persoais. A súa publicación require unha base xurídica adecuada e o cumprimento das condicións de protección de datos.'),
('proteccion-datos.md', 'Protección de datos', 'Os contrasinais das contas educativas son persoais e non deben compartirse con outros usuarios.'),
('proteccion-datos.md', 'Protección de datos', 'Os documentos que conteñen información persoal do alumnado deben almacenarse en sistemas autorizados e con acceso restrinxido.'),
('tutoria.md', 'Titoría', 'O titor ou titora realiza o seguimento académico do grupo e coordina a comunicación entre o alumnado, as familias cando corresponda e o equipo docente.'),
('tutoria.md', 'Titoría', 'As reunións de titoría permiten identificar dificultades de aprendizaxe, problemas de asistencia e necesidades de apoio educativo.'),
('tutoria.md', 'Titoría', 'Cando un alumno presenta dificultades académicas persistentes, o titor debe coordinarse co profesorado do grupo para valorar posibles medidas de apoio.'),
('tutoria.md', 'Titoría', 'A orientación académica e profesional axuda o alumnado a coñecer as posibles saídas laborais e as opcións para continuar os seus estudos.'),
('formacion-empresa.md', 'Formación en empresa', 'A formación en empresa permite ao alumnado aplicar nun contorno profesional real os coñecementos e competencias adquiridos no centro educativo.'),
('formacion-empresa.md', 'Formación en empresa', 'O alumnado debe cumprir o horario e as normas de funcionamento da empresa durante o período de formación.'),
('formacion-empresa.md', 'Formación en empresa', 'O titor ou titora do centro realiza o seguimento da formación en empresa en coordinación co titor designado pola empresa.'),
('formacion-empresa.md', 'Formación en empresa', 'As actividades desenvolvidas na empresa deben estar relacionadas cos resultados de aprendizaxe previstos no plan de formación.'),
('seguridade.md', 'Seguridade informática', 'O alumnado debe apagar correctamente os equipos informáticos ao finalizar as actividades e deixar ordenado o posto de traballo.'),
('seguridade.md', 'Seguridade informática', 'Non se permite instalar programas nos equipos do centro sen autorización do profesorado ou do persoal responsable dos sistemas.'),
('seguridade.md', 'Seguridade informática', 'Os ficheiros descargados de Internet deben analizarse cun sistema de protección antes de executalos, especialmente cando proceden de fontes descoñecidas.'),
('seguridade.md', 'Seguridade informática', 'As copias de seguridade permiten recuperar información ante fallos de hardware, erros humanos ou ataques informáticos. Deben realizarse periodicamente.'),
('seguridade.md', 'Seguridade informática', 'As conexións ás redes sen fíos do centro deben realizarse utilizando os mecanismos de autenticación establecidos pola administración educativa.');
O campo embedding queda inicialmente baleiro. Máis adiante, embedding.py
encherá ese campo cos vectores xerados por Ollama.
Os scripts de /docker-entrypoint-initdb.d/ execútanse cando PostgreSQL crea a
base de datos no volume. Se modificas init.sql despois de crear
postgres_data, os cambios non se aplicarán automaticamente. Para repetir a
inicialización nunha práctica local podes deter o proxecto e eliminar o volume,
pero esa operación tamén elimina os datos gardados nel.
Nesta práctica aplicamos o proceso explicado en Embeddings e bases de datos vectoriais: gardamos cada fragmento xunto co seu vector, convertemos a pregunta nun vector e recuperamos os fragmentos semanticamente máis próximos.
Iniciar o sistema
Antes de iniciar os servizos debemos construír a imaxe do Dockerfile do
servizo Python. A opción --build forza esa construción:
docker compose up -d --build
-d deixa os contedores executándose en segundo plano. Comprobamos o estado:
docker ps
Durante os primeiros minutos podemos ver tres contedores. Serían estes:
CONTAINER ID   IMAGE                             COMMAND                  CREATED          STATUS          PORTS                                             NAMES
f659c89bc97c   ollama/ollama                     "/bin/sh -c 'until o…"   15 seconds ago   Up 14 seconds   11434/tcp                                         ollama-init
c35287fb7571   pgvector/pgvector:pg17-bookworm   "docker-entrypoint.s…"   15 seconds ago   Up 13 seconds   0.0.0.0:5433->5432/tcp, [::]:5433->5432/tcp       rag-postgres
a8037b667414   ollama/ollama                     "/bin/ollama serve"      15 seconds ago   Up 14 seconds   0.0.0.0:11434->11434/tcp, [::]:11434->11434/tcp   ollama
Se aparece ollama-init, aínda se están descargando os modelos. Pode tardar
varios minutos. Non avances ata que desapareza ese contedor.
Podemos consultar os modelos dispoñibles con:
docker exec -it ollama ollama list
A saída debe incluír qwen2.5:3b e nomic-embed-text:
NAME                     ID              SIZE      MODIFIED
qwen2.5:3b               357c53fb659c    1.9 GB    48 seconds ago
nomic-embed-text:latest  0a109f422b47    274 MB    3 minutes ago
Se aínda non aparecen os dous modelos, podemos seguir o proceso con:
docker compose logs -f ollama-init
Prememos Ctrl+C para saír da vista dos logs. Cando a descarga remate,
docker ps debe mostrar unicamente rag-postgres e ollama.
Comprobar PostgreSQL
Conectámonos á base de datos dende o contedor:
docker exec -it rag-postgres psql -U rag -d rag
Dentro de psql, agrupamos os fragmentos por categoría:
SELECT categoria, COUNT(*)
FROM fragmentos
GROUP BY categoria
ORDER BY categoria;
O resultado esperado é:
       categoria        | count
------------------------+-------
 Asistencia             |     5
 Avaliación             |     6
 Convivencia            |     5
 Formación en empresa   |     4
 Protección de datos    |     5
 Recursos educativos    |     7
 Seguridade informática |     5
 Titoría                |     4
(8 rows)
Para saír de psql escribimos \\q ou prememos Ctrl+D.
Xerar os embeddings
Agora executamos o programa Python dentro dun contedor temporal. O perfil
app permite que o servizo Python se utilice baixo demanda, sen mantelo
executándose continuamente:
docker compose run --rm python python embedding.py
O proceso debe rematar coa mensaxe:
Todos os embeddings foron xerados.
Comprobamos que os 41 fragmentos teñen xa un embedding:
docker exec -it rag-postgres psql -U rag -d rag
SELECT
    COUNT(*) AS total,
    COUNT(embedding) AS con_embedding
FROM fragmentos;
O resultado esperado é:
 total | con_embedding
-------+---------------
    41 |            41
Probar o modelo de embeddings
O endpoint /api/embed de Ollama pode converter unha pregunta nun vector:
curl http://localhost:11434/api/embed \
  -d '{
    "model": "nomic-embed-text",
    "input": "Como se recupera unha avaliación suspensa?"
  }'
A resposta contén un vector con 768 valores. Esa dimensión debe coincidir coa
definida na columna embedding VECTOR(768).
Facer preguntas ao asistente
Executamos o programa de consulta:
docker compose run --rm python python buscar.py
O programa pedirá unha pregunta. Probamos cunha cuestión relacionada cos documentos:
Que debo facer se un alumno acumula moitas faltas de asistencia?
O sistema amosará primeiro os fragmentos recuperados mediante proximidade vectorial e despois a resposta xerada polo modelo:
--- CONTEXTO RECUPERADO ---

Documento: asistencia.md
Categoría: Asistencia
Similitude: 0.8442
Contido: Cando un alumno acumula faltas de asistencia inxustificadas, o titor debe contactar co alumno para coñecer os motivos e intentar solucionar a situación.

Documento: asistencia.md
Categoría: Asistencia
Similitude: 0.7552
Contido: Se un alumno menor de idade falta reiteradamente ás clases, o centro debe informar as persoas responsables legais segundo o protocolo de absentismo.

--- RESPOSTA DO ASISTENTE ---

Se un alumno acumula moitas faltas de asistencia, o titor debe contactar co alumno para coñecer os motivos e intentar solucionar a situación. Se o problema persiste, e se o alumno é menor de idade, o centro debe informar as persoas responsables legais segundo o protocolo de absentismo.
A resposta baséase nos fragmentos recuperados, non nunha consulta directa a Internet.
Probar unha pregunta allea aos documentos
Agora facemos unha pregunta que non está relacionada coa información do centro:
Cal é a mellor época para recoller cogomelos en Galicia?
É posible que o sistema recupere fragmentos con similitude baixa, porque sempre ten que comparar a pregunta cos datos existentes. O asistente, porén, debe recoñecer que non hai información suficiente:
Non hai información suficiente na base de datos proporcionada para responder a
esa pregunta sobre a mellor época para recoller cogomelos en Galicia.
Este comportamento é importante: un RAG útil non debe presentar como feitos información que non aparece nos documentos proporcionados.
Que sucede durante unha consulta?
O programa buscar.py realiza estes pasos:
- Le a pregunta escrita pola persoa usuaria.
- Pídelle a Ollama o embedding da pregunta.
- Compara ese vector cos embeddings almacenados en PostgreSQL mediante
pgvector. - Recupera os fragmentos máis próximos.
- Envía a pregunta e o contexto recuperado ao modelo
qwen2.5:3b. - Mostra a resposta do asistente.
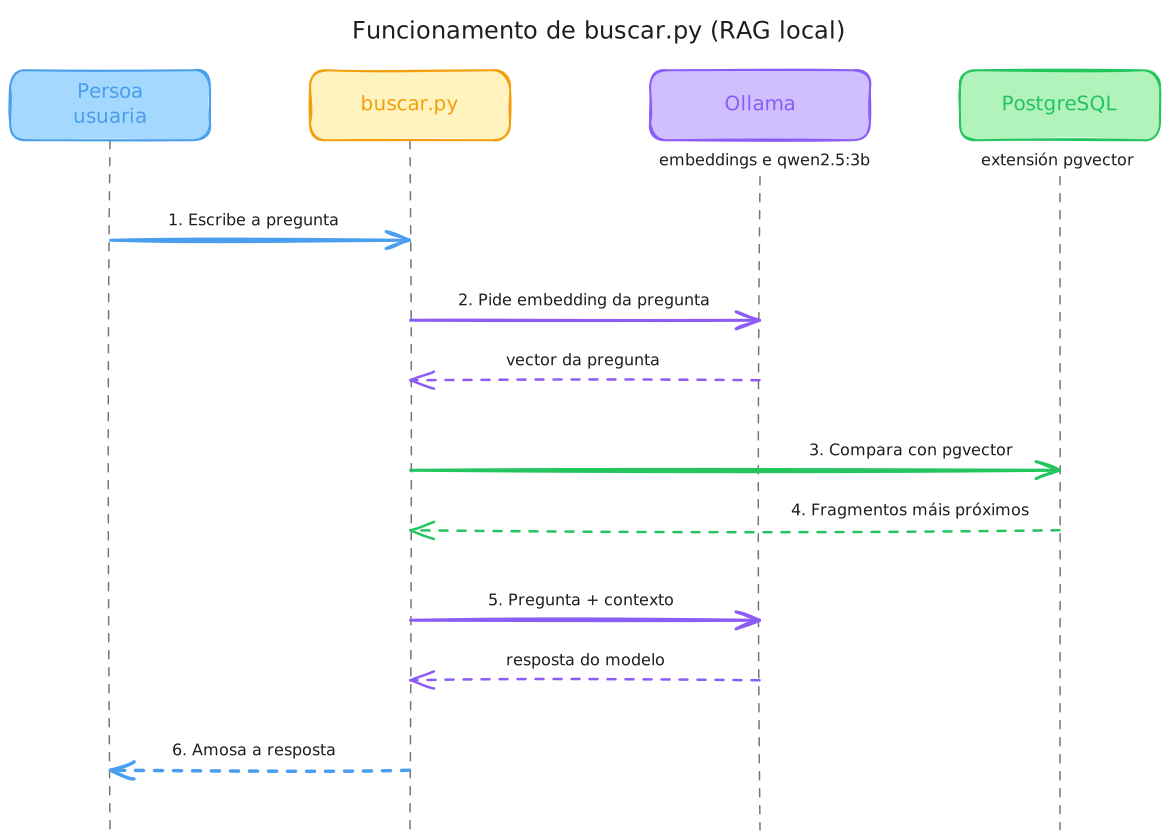
O modelo non recibe os 41 fragmentos en cada consulta. Recibe só os que o programa considera máis relacionados coa pregunta.
Resumo
- PostgreSQL con
pgvectoralmacena os fragmentos e os seus embeddings. - Ollama executa localmente os modelos
nomic-embed-texteqwen2.5:3b. ollama-initdescarga os modelos ao iniciar o proxecto por primeira vez.embedding.pyenche a columna vectorial dos fragmentos.buscar.pyrecupera os fragmentos máis próximos e constrúe a resposta.- Se a información non está nos documentos, o asistente debe indicalo en vez de inventar unha resposta.